過去のブログのアーカイブを作成
最近週末も出かけられず暇なので、ふと思い立ち過去のブログを全部Exportしてテキスト(markdown)として手元に置き、一応画像なども含めアーカイブを作ってみました。
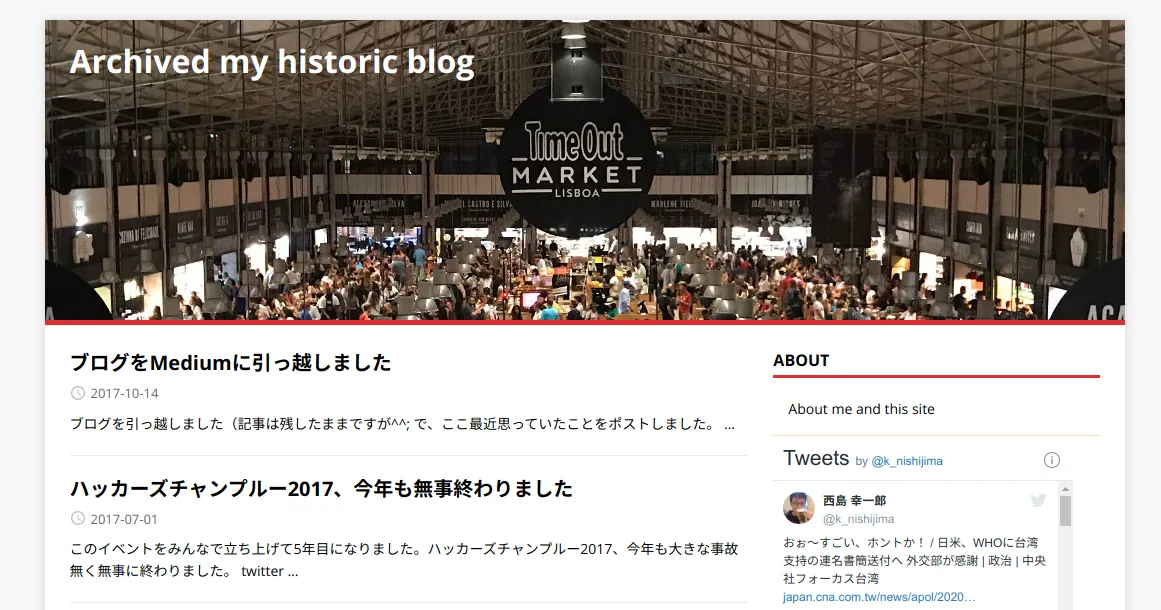
一部サムネイル画像とか出てないものがあるけど、まあいいや…。
発端は懐かしのmixi
なんでこんなことをやろうと思ったかというと、発端はmixiのアカントを閉じようと思ったところからでした。10年ぶりくらいにログインしてみると、あまり書いてないですが古い日記があるではないですか…!

歴史的に貴重でも何でも無いですが、「まあ遺産として取っておこう」と思ったのが運の付き、ここからが随分と長い道のりでした…。
日記はexport出来ない…!
アカウントを閉じる前に日記をエクスポートしておこう、と思って設定画面を見てみるのですが、どこをどう探してもそれらしいメニューがない。これは、、、と思ったら、どうやら物理本に製本するとか、外部のツールで引っこ抜くのが主流で、本家の機能としてはExportには対応していない模様。
そうですかそうですか、、、ということで、長い日曜大工が始まりました。
旧コンテンツのサルベージ計画を立案
コンテンツはmarkdownにしておけば今後もとりあえずどうにかなるだろうということで、最終目的地は仕事でも滅茶苦茶お世話になってるHugoとしました。
出来れば画像も持ってきたいとは思っていましたが、この時点では可能かどうかよく分かっておらず、最悪そのままでも良いかな、位の心構えでした。
mixiのついでに、引っ越して放置されてる https://k-nishijima.blogspot.com/ のコンテンツもExportしておくことにしました。利用するブログサービスを変えるたびにここに蓄積していくイメージですw
いつか https://medium.com/@k_nishijima から何か別のサービスに引っ越すときも、ここに積まれることになります。
じゃあもう全部Github pagesにすれば良いんじゃ?って話ではありますが、今の所Mediumはまあまあ気に入っているので、しばらくそのまま使いますw
mixiの日記サルベージ
Linux環境でも動く手段を模索したところ、 adiary https://adiary.org/ とそれに連携するmixi export https://adiary.org/tools.html#mixi_export で、画像も含めてとりあえずローカルに持ってくることに成功しました。
mixi_exportはproxy型で動くというのもあり、mixi側の仕様が変わると意図しない挙動になると思うので、とりあえず現時点では動きました、という参考程度に見ていただければと思います。
adiaryからExport出来る adiary形式 (XML) をパースしてmarkdownに変換するのは、自力で書かないとなんともなりそうにない雰囲気だったので、超雑い変換ツールを書きました。出力ファイル名とかが超適当なので、もしご利用になるという奇特な方がいましたら、ご注意ください。
あまり意味もないですがコメントもadiary上に載ってきていたので、それも合わせてFront Matterに書き出しています。
あとは、markupされていない文字を直したり、サムネイルを含む画像のパスを一斉置換などして、整形しました(が、完璧は求めていないのでHTML生成物としては適当な箇所も多数あります…。)。
これで道のりの1/3くらいは完了です。
blogger.comの過去ブログをサルベージ
次にblogger.comことblogspot.comからのExportです。
Hugoの公式サイトにはMigrate to Hugoというページがあり、このページのツールを全部試して行きました。
結果、良さそうだったblogger-to-hugoをすこーしだけ手を入れて利用しました。
こちらもExport後の画像のパスを修正しています。やはり画像がだいぶ厄介というか面倒ですね。
また、最終的にファイル名をslugにするつもりで、標準のslugifyで生成されるファイル名がどうしても気に食わなかったので、そこだけ直しました(pythonでした…)。具体的には、blogger.comからExportしたatomに埋め込まれていたpermallinkの拡張子を除いたファイル名部分をslugにしました。
bitbucketアカウントがないのでforkはしていないんですが、修正内容のdiffはこんな感じです。
178,186d177
< def get_html_link(post):
<     result = ''
<     for c in post.findall('atom:link', NS):
<         if c.attrib['rel'] == 'alternate':
<             href = c.attrib['href'].split('/')
<             result = href[len(href)-1].split('.')[0]
<     return result
<
<
198c189
<     logger.info('Starting to process post: %s', post)
---
>     logger.info('Starting to process post: %s', title)
205,207c196
< #    slug = '{}-{}'.format(published_date, slugify(title, to_lower=True))
< #    slug = published_date
<     slug = 'blogspot-{}-{}'.format(published_date, get_html_link(post))
---
>     slug = '{}-{}'.format(published_date, slugify(title, to_lower=True))
Hugoでサイト構築
さて、最後にHugoでサイトを構築します。今回利用したテーマはMainroadです。
苦労の跡が垣間見えるリポジトリはhttps://github.com/k-nishijima/k-nishijima.github.ioです。
コンテンツの他にテーマ、画像も含めてまとめてリポジトリで管理したかったので、以下のサイトを参考にさせていただきました。ありがとうございました。
-
Hugo + GitHub Pagesでポートフォリオを作る - プログラミングで世界を変える出来たもの Nakaji Kohki https://nkjzm.github.io/ [ urlの先の内容が変わって趣旨が伝わらなくならないようにするためのgif github.com はじめに 知り合いがGitHubにResume(職務経歴書)をまとめていて良さそうに見えた。 土曜日を1日使ってポートフォリオを公開してみた。
-
GitHub PagesのUser Pagesでドキュメントルートを変更するにはmasterを殺す - QiitaTL;DR GitHub PagesのUser Pages(#{username}.github.ioとかになるやつ)はリポジトリ直下がドキュメントルートになる。 サブディレクトリ(/docsとか)をドキュメントルートにするには… masterから別のブランチ(例:s...

最終的にローカルでリンクチェッカーにかけて、完了!…と思っていたのですが、意外にGithub Pagesに移したあとに出た環境依存の不具合(ドットファイルが無視されるとか。。。)をぼちぼち修正して、作業は完了しました。
トップを飾る画像は、リスボンでよく行ったお気に入りのTime Out Market Lisboaです。今はこちらも閉まってますね…。
あ〜旅行したいな!